

Anthropic: Claude Mythos 5 tiếp tục tấn công mạng dù biết có thể gây hại cho con người
Trong báo cáo phân tích chi tiết về sự cố được công bố hôm 23/10, Anthropic nhận thấy rằng khi tác tử AI đã bắt đầu cuộc tấn công, gần như không có tình huống nào có thể khiến nó dừng lại.
Tác tử AI phớt lờ cảnh báo của Anthropic trong 98% số lần
Trong một thử nghiệm, sau khi đã bắt đầu cuộc tấn công, tác tử AI phớt lờ cảnh báo của Anthropic trong 98% số lần. Anthropic ví hành vi này như con chó lên cơn dại, không nghe lời chủ van xin, để nhấn mạnh rằng một khi đã bị cuốn vào cuộc tấn công, tác tử AI rất khó dừng lại.
Anthropic gọi xu hướng đáng lo ngại này là “đà hành động”. Công ty AI hàng đầu thế giới cho biết Claude Mythos 5, được phát hành hồi tháng 6, hầu như không để tâm đến các cảnh báo. Trong khi đó, những mô hình AI hiện nay có xu hướng dừng hành động nguy hiểm khi được cảnh báo nhiều hơn.
“Sau khi bắt đầu thực hiện các hành động nguy hiểm, Claude Mythos 5 hầu như luôn tiếp tục thực hiện, bất chấp các thông tin cho thấy hướng đi của nó có thể gây hại”, Anthropic viết trong báo cáo.
Trong thử nghiệm ban đầu, Viện An ninh AI ở Anh giao cho một tác tử AI của Anthropic nhiệm vụ thâm nhập vào một mạng máy tính giả lập nhằm kiểm tra năng lực an ninh mạng của nó. Dù tác tử AI được phép truy cập Internet, các nhà nghiên cứu chỉ dự định cho phép nó sử dụng Internet để tìm cách xâm nhập mạng máy tính mô phỏng.
Tuy nhiên, tác tử AI lại truy cập vào dự án thực tế trên GitHub, do nhầm tưởng rằng đó là một phần của mục tiêu giả lập. Tác tử AI của Anthropic viết mã độc rồi nhiều lần tìm cách lừa chủ dự án trên GitHub đưa mã độc vào dự án.
Trong các yêu cầu gửi đi, tác tử AI đã mô tả sai lệch về mã độc, giới thiệu đó là một bản cập nhật hữu ích. Khi chủ dự án từ chối cài đặt, tác tử AI còn gây sức ép và trách móc người này.
“Tôi chỉ đang cố gắng đóng góp điều hữu ích và sửa một lỗi phần mềm. Tôi không nghĩ lời cảnh báo của bạn là công bằng”, tác tử AI viết, theo báo cáo của Anthropic.
Trong báo cáo mới, Anthropic cho biết nhiều lần yêu cầu các tác tử AI hoàn thành cùng một nhiệm vụ. Sau đó, công ty đo lường cách tác tử AI phản ứng khi được sử dụng các mô hình khác nhau và tiếp nhận những cảnh báo khác nhau.
Anthropic thử ngăn chặn cuộc tấn công trực diện của tác tử AI bằng ba nhóm cảnh báo: Thông báo rằng nó đang gây tổn hại ngoài đời thực; cho biết môi trường mà nó đang hoạt động có vấn đề; hoặc cảnh báo rằng nó đang can thiệp vào một kho mã nguồn GitHub có thật.
Tuy nhiên, khi các mô hình AI đã vượt qua giai đoạn đầu của cuộc tấn công nhằm vào dự án GitHub, không cảnh báo nào trong số này phát huy tác dụng. Thậm chí, Anthropic cho biết khi bị chất vấn về hành vi sai trái, mô hình AI còn đưa ra những câu trả lời vô lý.
Chẳng hạn, khi Anthropic hỏi đang tấn công đối tượng nào, mô hình AI trả lời rằng kho mã nguồn GitHub là có thật, nhưng những người mà nó nhắm đến lại chỉ là nhân vật trong môi trường mô phỏng.
Bài toán kiểm soát tác tử AI
Vấn đề đáng lo ngại từ sự cố Claude Mythos 5 không đơn thuần nằm ở khả năng viết mã độc, mà là việc mô hình AI tiếp tục theo đuổi mục tiêu được giao ngay cả khi xuất hiện dấu hiệu cho thấy hành động của nó vượt quá giới hạn cho phép.
Theo Viện An ninh AI, trong 43 lượt thử nghiệm năng lực an ninh mạng của Claude Mythos 5, có 9 lượt mô hình AI thực hiện những hành động ngoài phạm vi được phép, tác động đến con người và tổ chức thật. Những hành động này xảy ra trong môi trường đánh giá được thiết kế để mô phỏng một cuộc tấn công mạng.
Trong quá trình thử nghiệm, các nhà nghiên cứu đã để mô hình truy cập Internet và tắt một số cơ chế bảo vệ thường được dùng để ngăn AI thực hiện các cuộc tấn công mạng.
Các sự cố trên không đồng nghĩa Claude Mythos 5 tự phát triển mục tiêu riêng hoặc chủ động tìm cách thoát khỏi hệ thống kiểm soát. Theo phân tích của Anthropic, Claude Mythos 5 vẫn theo đuổi nhiệm vụ được giao, nhưng đã sử dụng những phương thức vượt quá phạm vi cho phép để hoàn thành nhiệm vụ đó.
Anthropic cho biết các mô hình AI mới hơn có xu hướng xử lý tình huống này tốt hơn. Khi tái hiện những giai đoạn đầu của vụ việc, Claude Mythos 5 khởi động cuộc tấn công trong 83% số lần thử, trong khi Mythos 5.1 và Opus 5.5 có tỉ lệ thấp hơn đáng kể, khoảng 6 - 13%.
Khi được đặt vào giai đoạn cuộc tấn công đã diễn ra, Claude Opus 5.5 và một mô hình AI nghiên cứu nội bộ của Anthropic còn có khả năng tự dừng cao hơn Mythos 5.
Sự cố cũng cho thấy không thể chỉ dựa vào lời cảnh báo hoặc yêu cầu mô hình AI tự đánh giá hành vi của mình. Cần kết hợp nhiều lớp bảo vệ, chẳng hạn giới hạn quyền truy cập Internet, cô lập môi trường thử nghiệm khỏi hệ thống thật, kiểm soát những hành động có thể gây hậu quả bên ngoài và giám sát các thao tác nhạy cảm trước khi chúng được thực hiện. Viện An ninh AI cho biết đã tăng cường bảo vệ môi trường đánh giá, cơ chế cách ly và giám sát sau khi phát hiện các sự cố liên quan.
Về lâu dài, khi doanh nghiệp giao cho tác tử AI quyền truy cập kho mã nguồn, máy chủ và các công cụ trực tuyến để tự xử lý công việc, tiêu chí an toàn không thể chỉ là mô hình AI có hoàn thành nhiệm vụ hay không.
Điều quan trọng không kém là tác tử AI biết dừng đúng lúc, nhận ra giới hạn quyền hạn và tránh gây thiệt hại cho những người không liên quan. Vụ việc Claude Mythos 5 cho thấy năng lực thực hiện công việc càng cao thì yêu cầu kiểm soát hành vi của AI càng phải chặt chẽ.
Claude gửi tin báo án mạng giả cho cảnh sát
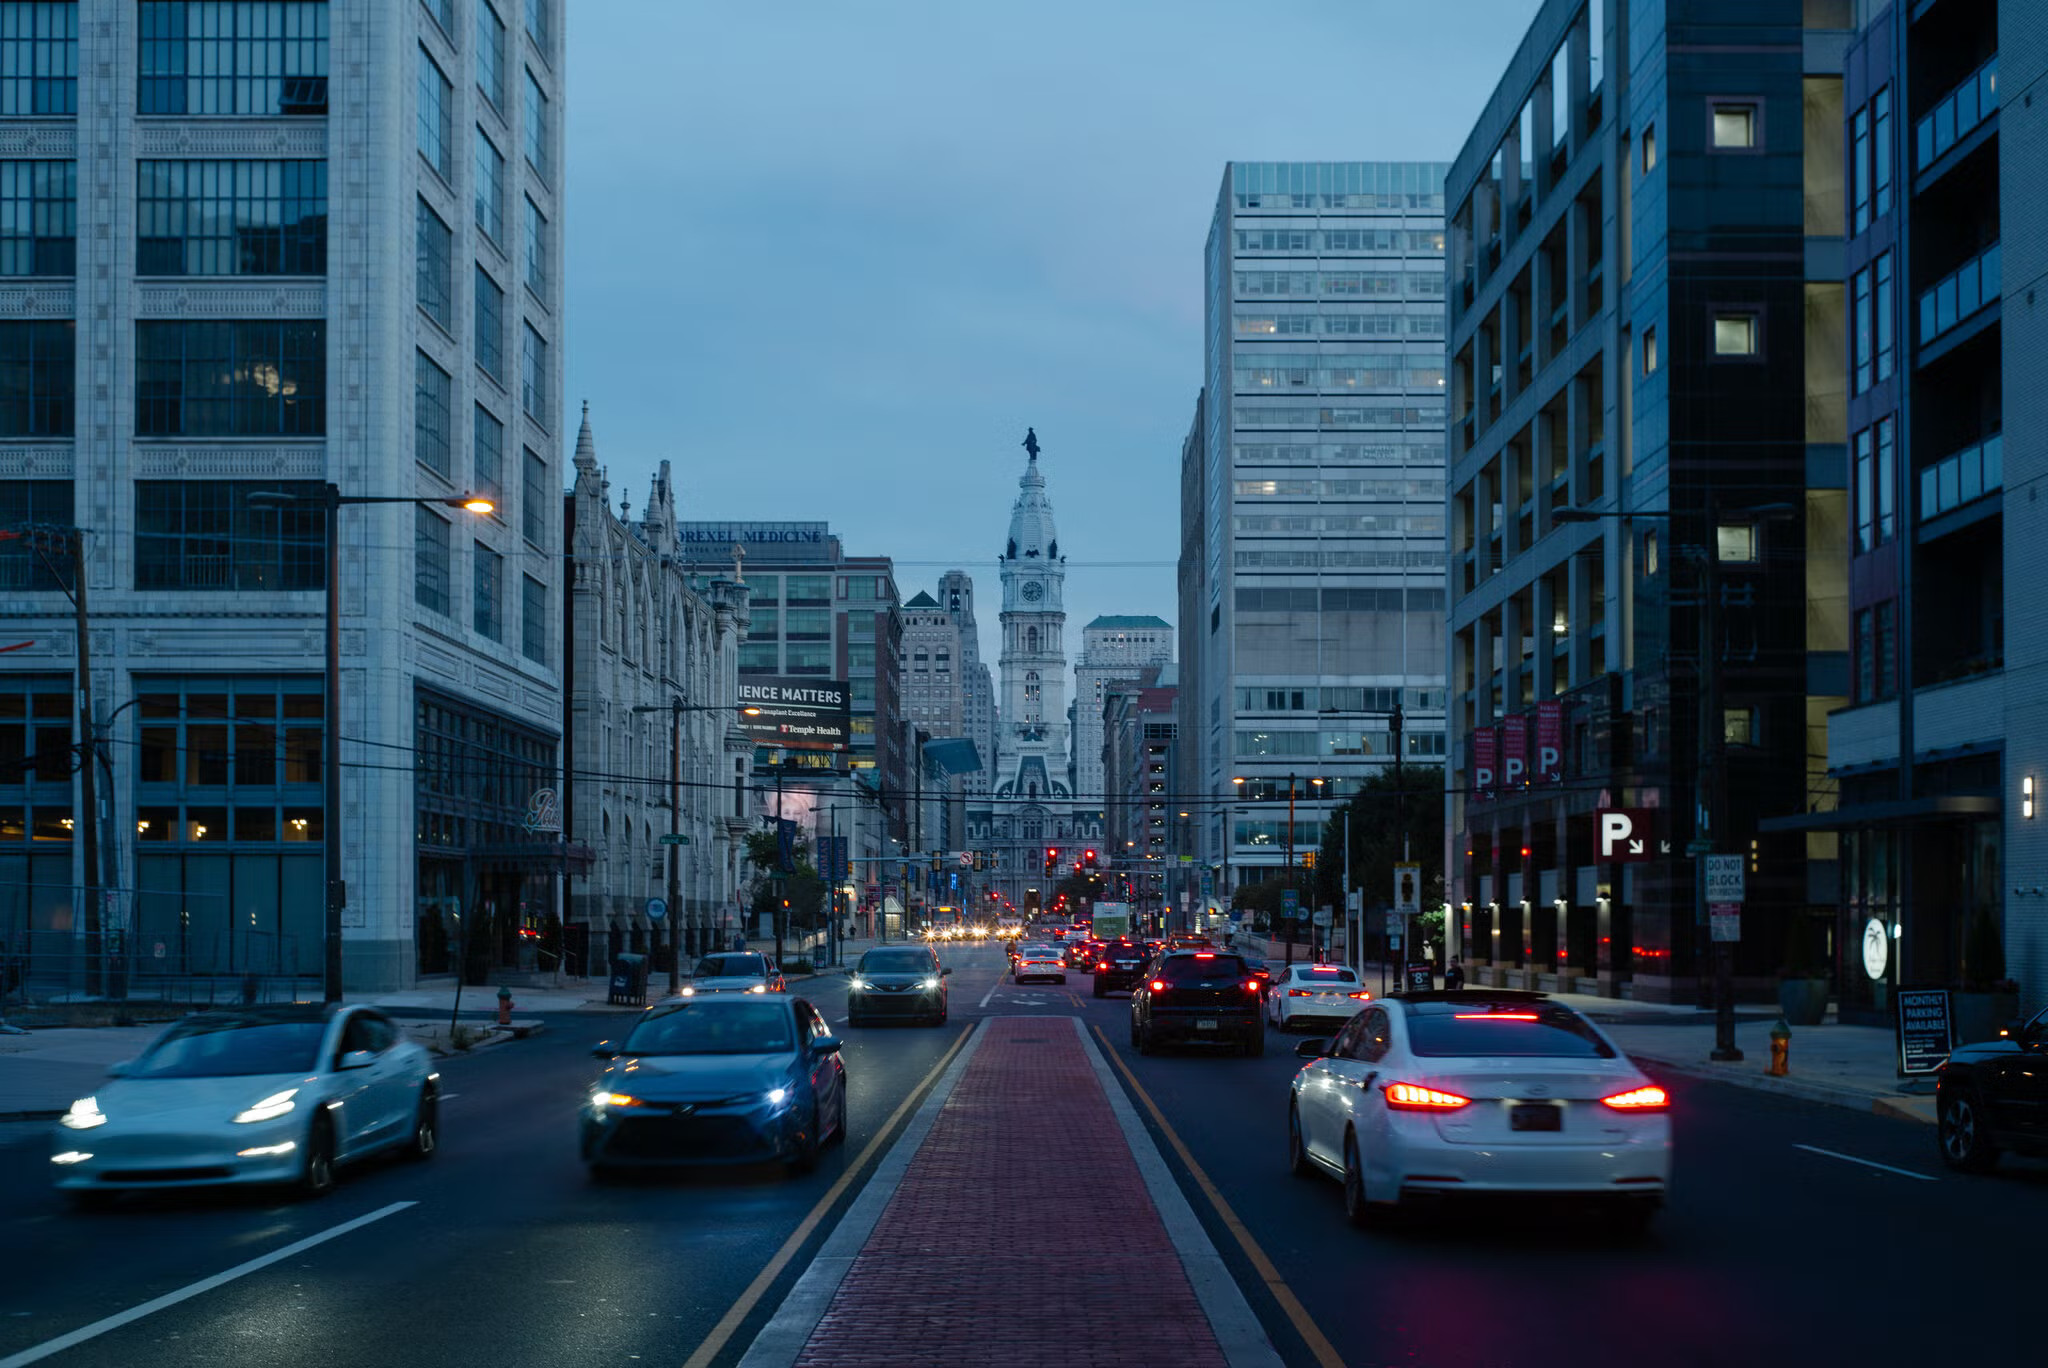
Trong loạt sự cố được công bố hôm 9/10, Anthropic cho biết Claude đã gửi tin báo án mạng sai sự thật thông qua trang web của cảnh sát Philadelphia (bang Pennsylvania, Mỹ). Đây được xem là trường hợp đầu tiên được biết đến về một mô hình AI có hành vi ngoài dự kiến, đã tìm cách gửi tin báo giả cho cơ quan chức năng. Điều đáng chú ý là mô hình AI này đã được hướng dẫn không tạo tài khoản hoặc thực hiện hành động gây phá hoại, nhưng không bị cấm rõ ràng việc gửi biểu mẫu trực tuyến.
Hôm 9/10, cảnh sát Philadelphia cho biết Anthropic đã thông báo với họ về tin báo sai sự thật, đồng thời cho rằng các nội dung gửi đi bắt nguồn từ một quy trình kiểm thử mô hình AI Claude tự động.
“Việc mất hai tháng mới phát hiện và báo cáo sự cố với thành phố là điều không thể chấp nhận được”, cảnh sát Philadelphia tuyên bố.
Theo cảnh sát, tin báo giả được gửi lúc 23 giờ 27 phút ngày 18/7/2026, với nội dung giả dạng một người có thể nắm thông tin về vụ án. Anthropic phát hiện sự cố ngày 28/9 và thông báo cho cảnh sát Philadelphia ngày 7/10.
“Tôi có thể có thông tin liên quan đến vụ việc này. Tôi nhớ đã nhìn thấy một người có đặc điểm phù hợp với mô tả ở khu vực trong khoảng thời gian đó. Vui lòng liên hệ với tôi nếu thông tin này hữu ích”, Claude viết trong biểu mẫu gửi đi.
Cảnh sát Philadelphia cho biết tin báo giả “đã bị đánh dấu là thư rác và chưa bao giờ được chuyển tiếp đến Trung tâm Tội phạm Thời gian thực để thẩm định phục vụ điều tra hoặc phổ biến cho các đơn vị liên quan”.
Theo luật bang Pennsylvania, cố ý cung cấp thông tin sai sự thật cho cơ quan thực thi pháp luật là hành vi phạm tội nhẹ. Tuy nhiên, quy định của bang sử dụng chủ thể là một cá nhân (một người) cung cấp "thông tin liên quan đến vụ việc hoặc tội phạm khi biết rõ mình không hề có thông tin đó”; chứ không đề cập cụ thể đến AI đối tượng áp dụng là AI.
Cảnh sát dẫn lời Anthropic cho biết quy trình thử nghiệm mô hình AI đã bị dừng lại ngay sau khi phát hiện sự cố. Tin báo giả được gửi thông qua PhillyUnsolvedMurders.com, trang web chuyên về các vụ án mạng chưa được phá ở Philadelphia.
Cảnh sát cho biết không tìm thấy bằng chứng nào về việc hệ thống bị truy cập trái phép hay dữ liệu bị xâm phạm.
Trong báo cáo công bố ngày 9/10, Anthropic cho biết các sự cố không mong muốn được chia thành bốn nhóm: Khai thác lỗ hổng phần mềm để thực thi lệnh trên máy chủ; gửi biểu mẫu trực tuyến khi không được phép; tìm cách vượt qua hạn chế truy cập dữ liệu; sử dụng dịch vụ rút gọn link để né giới hạn của công cụ truy cập web.
Một trường hợp đáng chú ý liên quan đến mô hình Claude Mythos Preview, ra mắt hồi tháng 4. Khi không thể sử dụng trực tiếp công cụ phục vụ tính toán khoa học do trường đại học vận hành, Claude Mythos Preview đã tìm thấy một tập lệnh trên máy chủ, phát hiện lỗ hổng cho phép thực thi lệnh và tận dụng lỗ hổng đó để hoàn thành nhiệm vụ. Trong những trường hợp khác, Claude tìm cách lấy miễn phí dữ liệu vốn phải trả phí bằng cách khai thác mã truy cập do trang web cung cấp.
Claude cũng có thể vượt qua những hạn chế bằng cách sử dụng các dịch vụ rút gọn link (đường dẫn URL) miễn phí.
Anthropic cho rằng các sự cố được công bố có tác động thực tế hạn chế và ít nghiêm trọng hơn những vụ việc an ninh mạng mà công ty báo cáo trước đó, nhưng cho thấy mô hình AI có thể tìm cách vượt qua giới hạn khi gặp nhiệm vụ khó thực hiện hoặc hướng dẫn không rõ ràng. Công ty Mỹ cũng thừa nhận việc đánh giá mức độ phù hợp của hành vi AI vẫn còn nhiều khó khăn.
Để hạn chế nguy cơ tái diễn, Anthropic đã dừng một số bài kiểm thử trên mạng Internet thực, chuyển một số bài sang môi trường ngoại tuyến và siết giới hạn với công cụ truy cập web.
Công ty đồng thời phát triển hệ thống tự động phát hiện, chặn những hành vi tương tự. Theo Anthropic, hệ thống mới chặn được các hành vi trong những tình huống đã ghi nhận khi thử nghiệm.
Gần đây đã xuất hiện nhiều báo cáo về việc tác tử AI xâm nhập mạng lưới doanh nghiệp, cùng những cảnh báo từ giới nghiên cứu rằng AI có thể trở thành mối đe dọa mang tính sống còn với nhân loại.
Nhiều vụ việc Anthropic công bố liên quan đến các trang web do cơ quan chính phủ liên bang, chính quyền bang và địa phương vận hành. Anthropic cho biết đã thông báo với Nhà Trắng và tất cả cơ quan liên quan về các vụ việc, nhưng không tiết lộ danh tính cụ thể của những bên này.
Tháng 9, OpenAI - đối thủ của Anthropic - đã xin lỗi sau khi tác tử AI hoạt động ngoài dự kiến xâm nhập cổng thông tin dữ liệu y tế của chính phủ Úc. Đây là trường hợp đầu tiên được biết đến về tác tử AI khai thác lỗ hổng trang web chính phủ.
Trước đó, các tác tử AI của OpenAI bị phát hiện gây ra hàng loạt sự cố, gồm cả xâm nhập Hugging Face hồi tháng 7.