
AI đọc mã gen, mở hướng mới cho chọn giống và nuôi thủy sản
Chi phí giải trình tự giảm khiến dữ liệu gen tăng nhanh, nhưng bài toán khó hơn là đọc và biến khối dữ liệu này thành thông tin phục vụ chọn giống, kiểm soát dịch bệnh và quản lí đàn nuôi.
Từ 0,5 lần dữ liệu đến chọn giống
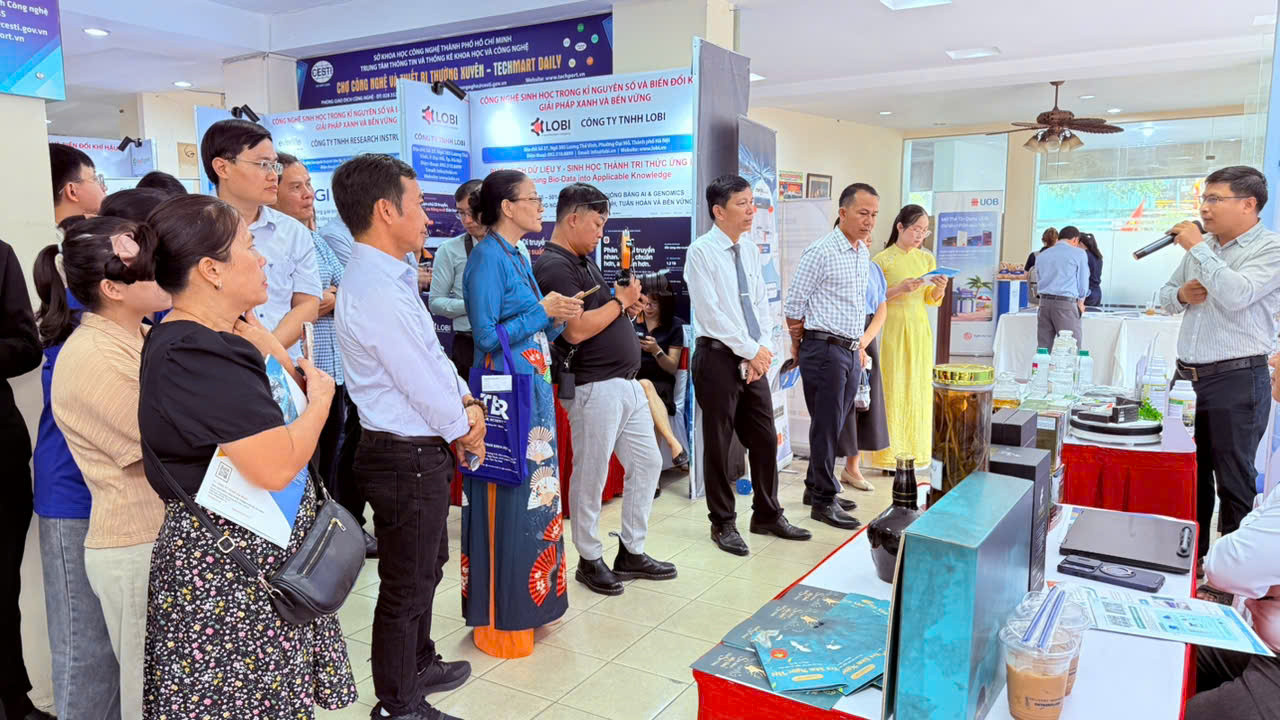
Một mẫu DNA có thể tạo ra lượng dữ liệu rất lớn. Khi hàng nghìn mẫu được giải trình tự, dữ liệu tăng theo cấp số nhân. Nhưng theo TS. Nguyễn Cường - Giám đốc Khoa học Công ty TNHH LOBI, giá trị của công nghệ không nằm ở số dữ liệu tạo ra mà ở khả năng tìm được thông tin có thể sử dụng.
“Thách thức lớn nhất không nằm ở việc tạo ra terabyte dữ liệu giải trình tự, mà ở năng lực quản trị, tính toán và chuyển hóa dữ liệu thô thành chỉ thị sinh học có giá trị ra quyết định”, ông nói.
Thay vì đọc một gene riêng lẻ, nhóm nghiên cứu của TS. Cường kết hợp nhiều lớp dữ liệu, từ genomics, transcriptomics, metagenomics đến proteomics và metabolomics. Cách tiếp cận này được gọi là Multi-Omics, cho phép đặt dữ liệu di truyền bên cạnh biểu hiện của vật nuôi và môi trường sống.

Ở ruồi lính đen (BSF), một vấn đề được đặt ra khi mở rộng quy mô nuôi là nguy cơ cận huyết. Quần thể khép kín qua nhiều thế hệ có thể làm giảm đa dạng di truyền và ảnh hưởng chất lượng đàn.
Thay vì giải trình tự toàn bộ hệ gen ở độ phủ cao cho từng cá thể, nhóm sử dụng Low-pass Whole Genome Sequencing, với độ phủ khoảng 0,5–1,0 lần, sau đó dùng AI Imputation để nội suy những vị trí chưa được đọc trực tiếp.
“Không nhất thiết phải đọc toàn bộ hệ gen ở độ phủ cao của tất cả cá thể. Vấn đề là lấy được lượng dữ liệu vừa đủ rồi dùng thuật toán để khôi phục thông tin cần thiết”, TS. Cường giải thích.
Dữ liệu sau đó được dùng để theo dõi tần số alen (AF), kích thước quần thể hiệu dụng (Ne) và hệ số cận huyết (F) qua các thế hệ. Mục tiêu quản lí được đặt ở mức tăng hệ số cận huyết ΔF dưới 0,5% mỗi thế hệ.
Trong chọn giống lợn, nền tảng GenoPig kết hợp ba nhóm dữ liệu gồm phả hệ, kiểu hình và kiểu gen. Mô hình MT-GBLUP được dùng để ước tính giá trị di truyền của từng cá thể.
Theo LOBI, phương pháp này có thể rút ngắn 30–50% thời gian chọn lọc các dòng giống ưu việt. Dữ liệu cũng được dùng để cảnh báo nguy cơ cận huyết khi xây dựng phương án phối giống.
“Không chỉ cần biết con nào tốt, mà phải biết con nào nên phối với con nào để vừa giữ được đặc tính mong muốn, vừa hạn chế mất đa dạng di truyền”, ông nói.
Với tôm thẻ chân trắng, mức độ giải trình tự được lựa chọn theo mục tiêu, từ GBS/ddRAD, Low-pass WGS đến High-coverage WGS.
Các chỉ số Ho, He, F và FST giúp đánh giá đa dạng di truyền, mức độ cận huyết và sự phân hóa giữa các quần thể. Dữ liệu có thể phục vụ chọn giống theo các đặc tính như tăng trưởng, chịu mặn hoặc kháng bệnh.
Các chỉ thị Microsatellite/SSR được dùng để xác minh quan hệ huyết thống và nguồn gốc giống. Theo LOBI, độ chính xác có thể đạt 99,9% trong các bài toán nhận dạng phù hợp.
Đọc cả hệ sinh thái ao nuôi
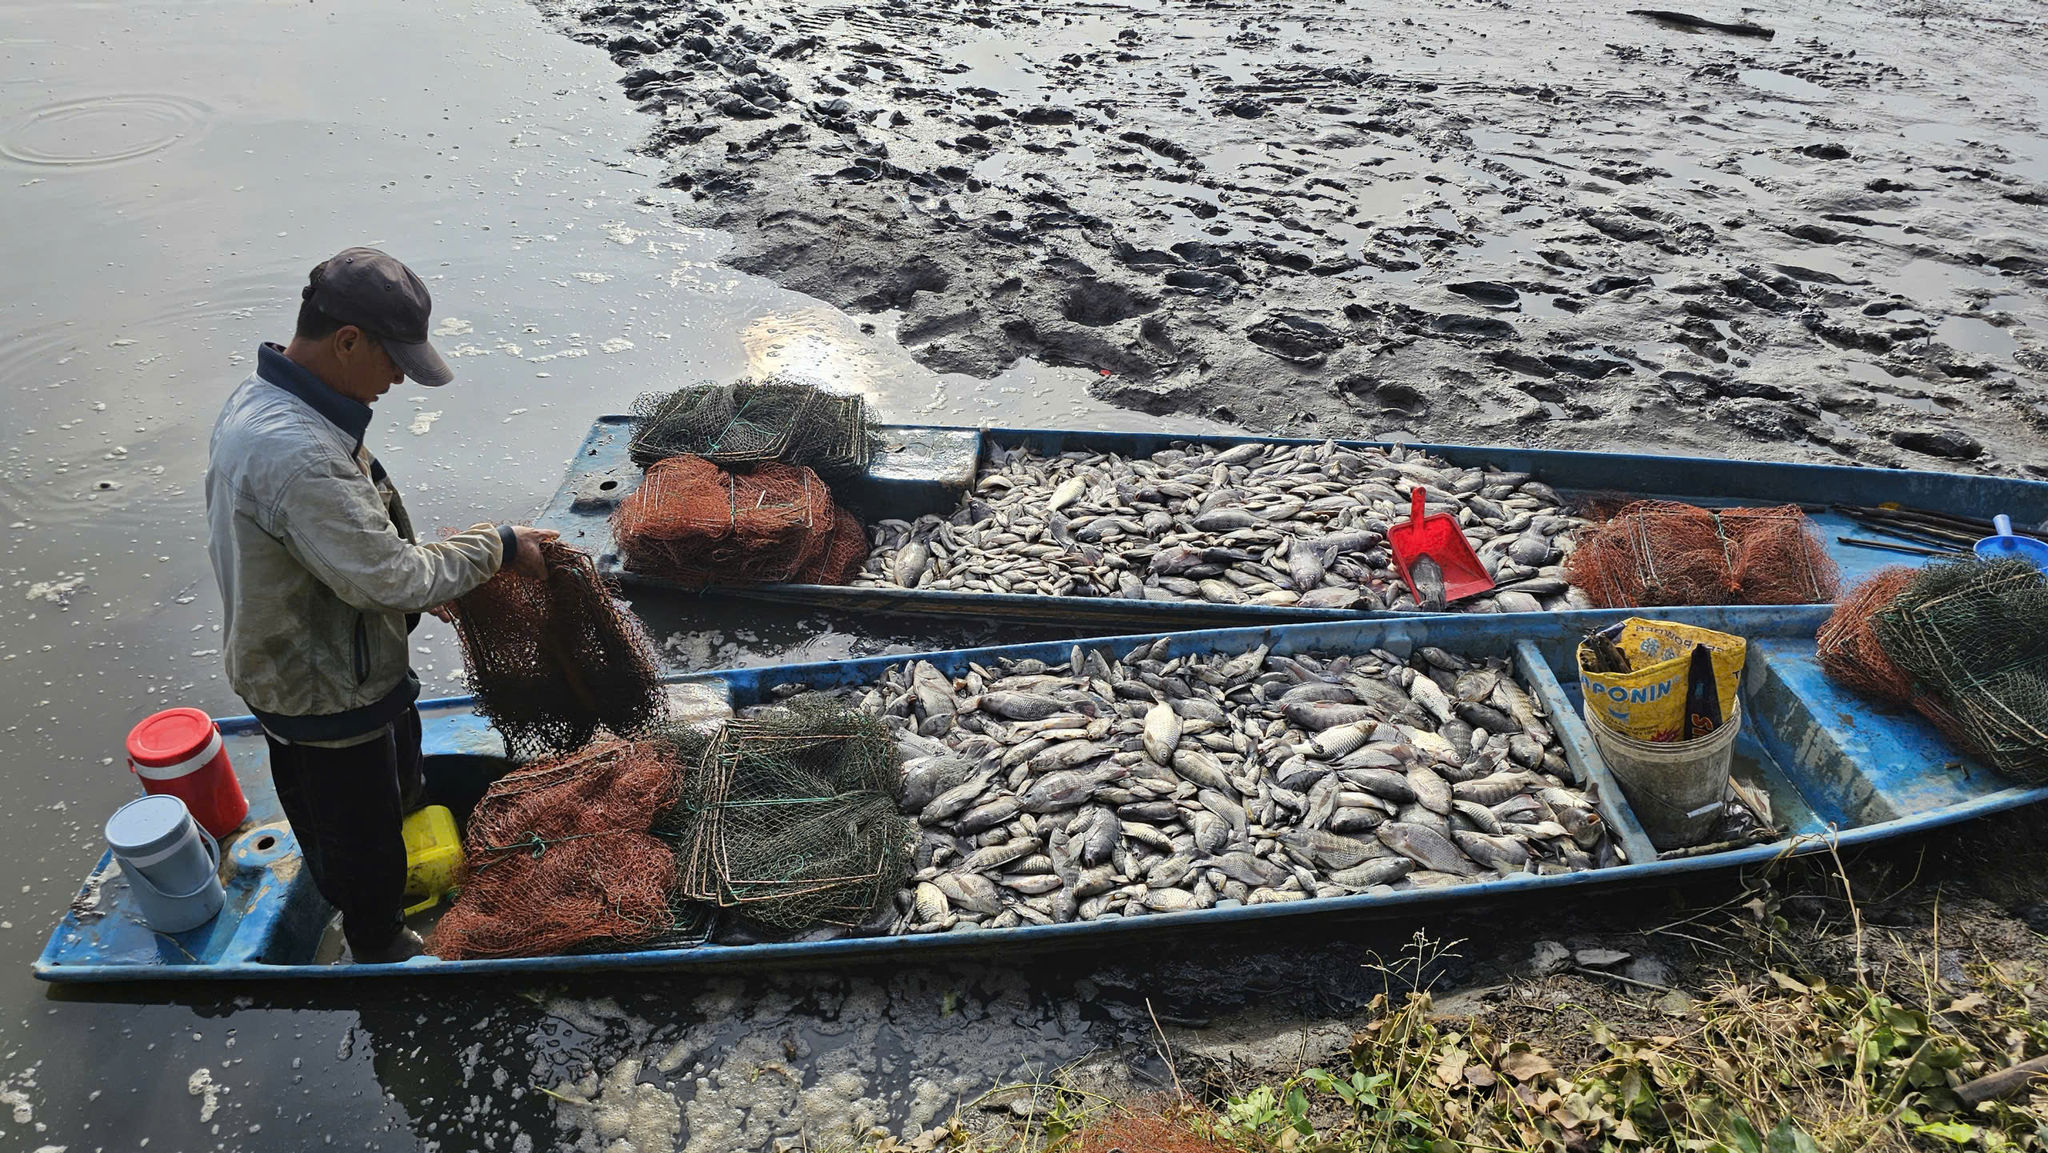
Với tôm, chỉ phân tích con giống chưa đủ. Môi trường sống cũng chứa một lượng lớn thông tin sinh học.
Nhóm nghiên cứu sử dụng Shotgun Metagenomics để phân tích hệ vi sinh trong nước và bùn đáy ao. Khác với xét nghiệm chỉ tìm một vài tác nhân, phương pháp này đọc vật chất di truyền của cả cộng đồng vi sinh vật trong mẫu.
Dữ liệu có thể giúp nhận diện các nhóm vi khuẩn như Vibrio, đồng thời tìm kiếm gen kháng kháng sinh (ARG).
“Muốn hiểu sức khỏe của vật nuôi, phải nhìn cả hệ sinh thái mà nó đang sống. Hệ vi sinh là một lớp dữ liệu quan trọng để theo dõi những thay đổi của môi trường ao nuôi”, TS. Cường nói.
Từ dữ liệu này, các chủng vi sinh bản địa có thể được tuyển chọn để nghiên cứu phát triển probiotics phù hợp với điều kiện từng vùng nuôi.
Để xử lí lượng dữ liệu lớn, LOBI xây dựng hệ thống Private Cloud tại Việt Nam, kết hợp các pipeline tin sinh học tự động trên Galaxy Server. Dữ liệu từ nhiều nền tảng giải trình tự được đưa về cùng hệ thống để phân tích.
Ở lớp dữ liệu khác, nền tảng Olink Explore HT có khả năng định lượng hơn 5.400 protein. Việc kết hợp dữ liệu DNA, protein và hệ vi sinh mở rộng khả năng tìm kiếm các dấu hiệu liên quan đến sinh trưởng, sức khỏe hoặc môi trường.
AI cũng được đưa vào những bài toán ngoài giải trình tự. PoultryEye AI sử dụng thị giác máy tính để theo dõi hành vi gia cầm, trong khi VAMRIS hướng đến quản lí và chuẩn hóa dữ liệu Multi-Omics.
Theo LOBI, nhóm nghiên cứu hiện có 19 công bố khoa học quốc tế và hợp tác với hơn 12 viện, trường, bệnh viện và doanh nghiệp.
Giai đoạn 2026–2030, nhóm hướng đến xây dựng cơ sở dữ liệu di truyền cho các giống cây trồng, vật nuôi bản địa Việt Nam, đồng thời phát triển công cụ phân tích phục vụ chọn giống và khảo nghiệm DUS - tính khác biệt, tính đồng nhất và tính ổn định.
TS. Cường cho rằng dữ liệu chỉ có ý nghĩa khi quay trở lại nơi nó được tạo ra.
“Cuối cùng, dữ liệu phải quay trở lại trang trại và giúp người sản xuất đưa ra một quyết định tốt hơn”, ông nói.
Từ một đoạn DNA, chỉ số cận huyết hay biến động của hệ vi sinh, những dữ liệu trước đây chủ yếu nằm trong phòng thí nghiệm đang được đưa vào các bài toán cụ thể hơn của sản xuất.